


Ralentir ? Encadrer ? Les discours alarmistes des géants de l’IA sont-ils vraiment motivés par la sécurité, ou par la peur de la stratégie chinoise ? Car Pékin casse les prix, ouvre ses modèles et redistribue les cartes. Une guerre sans merci qui pourrait bien profiter à l’Europe.
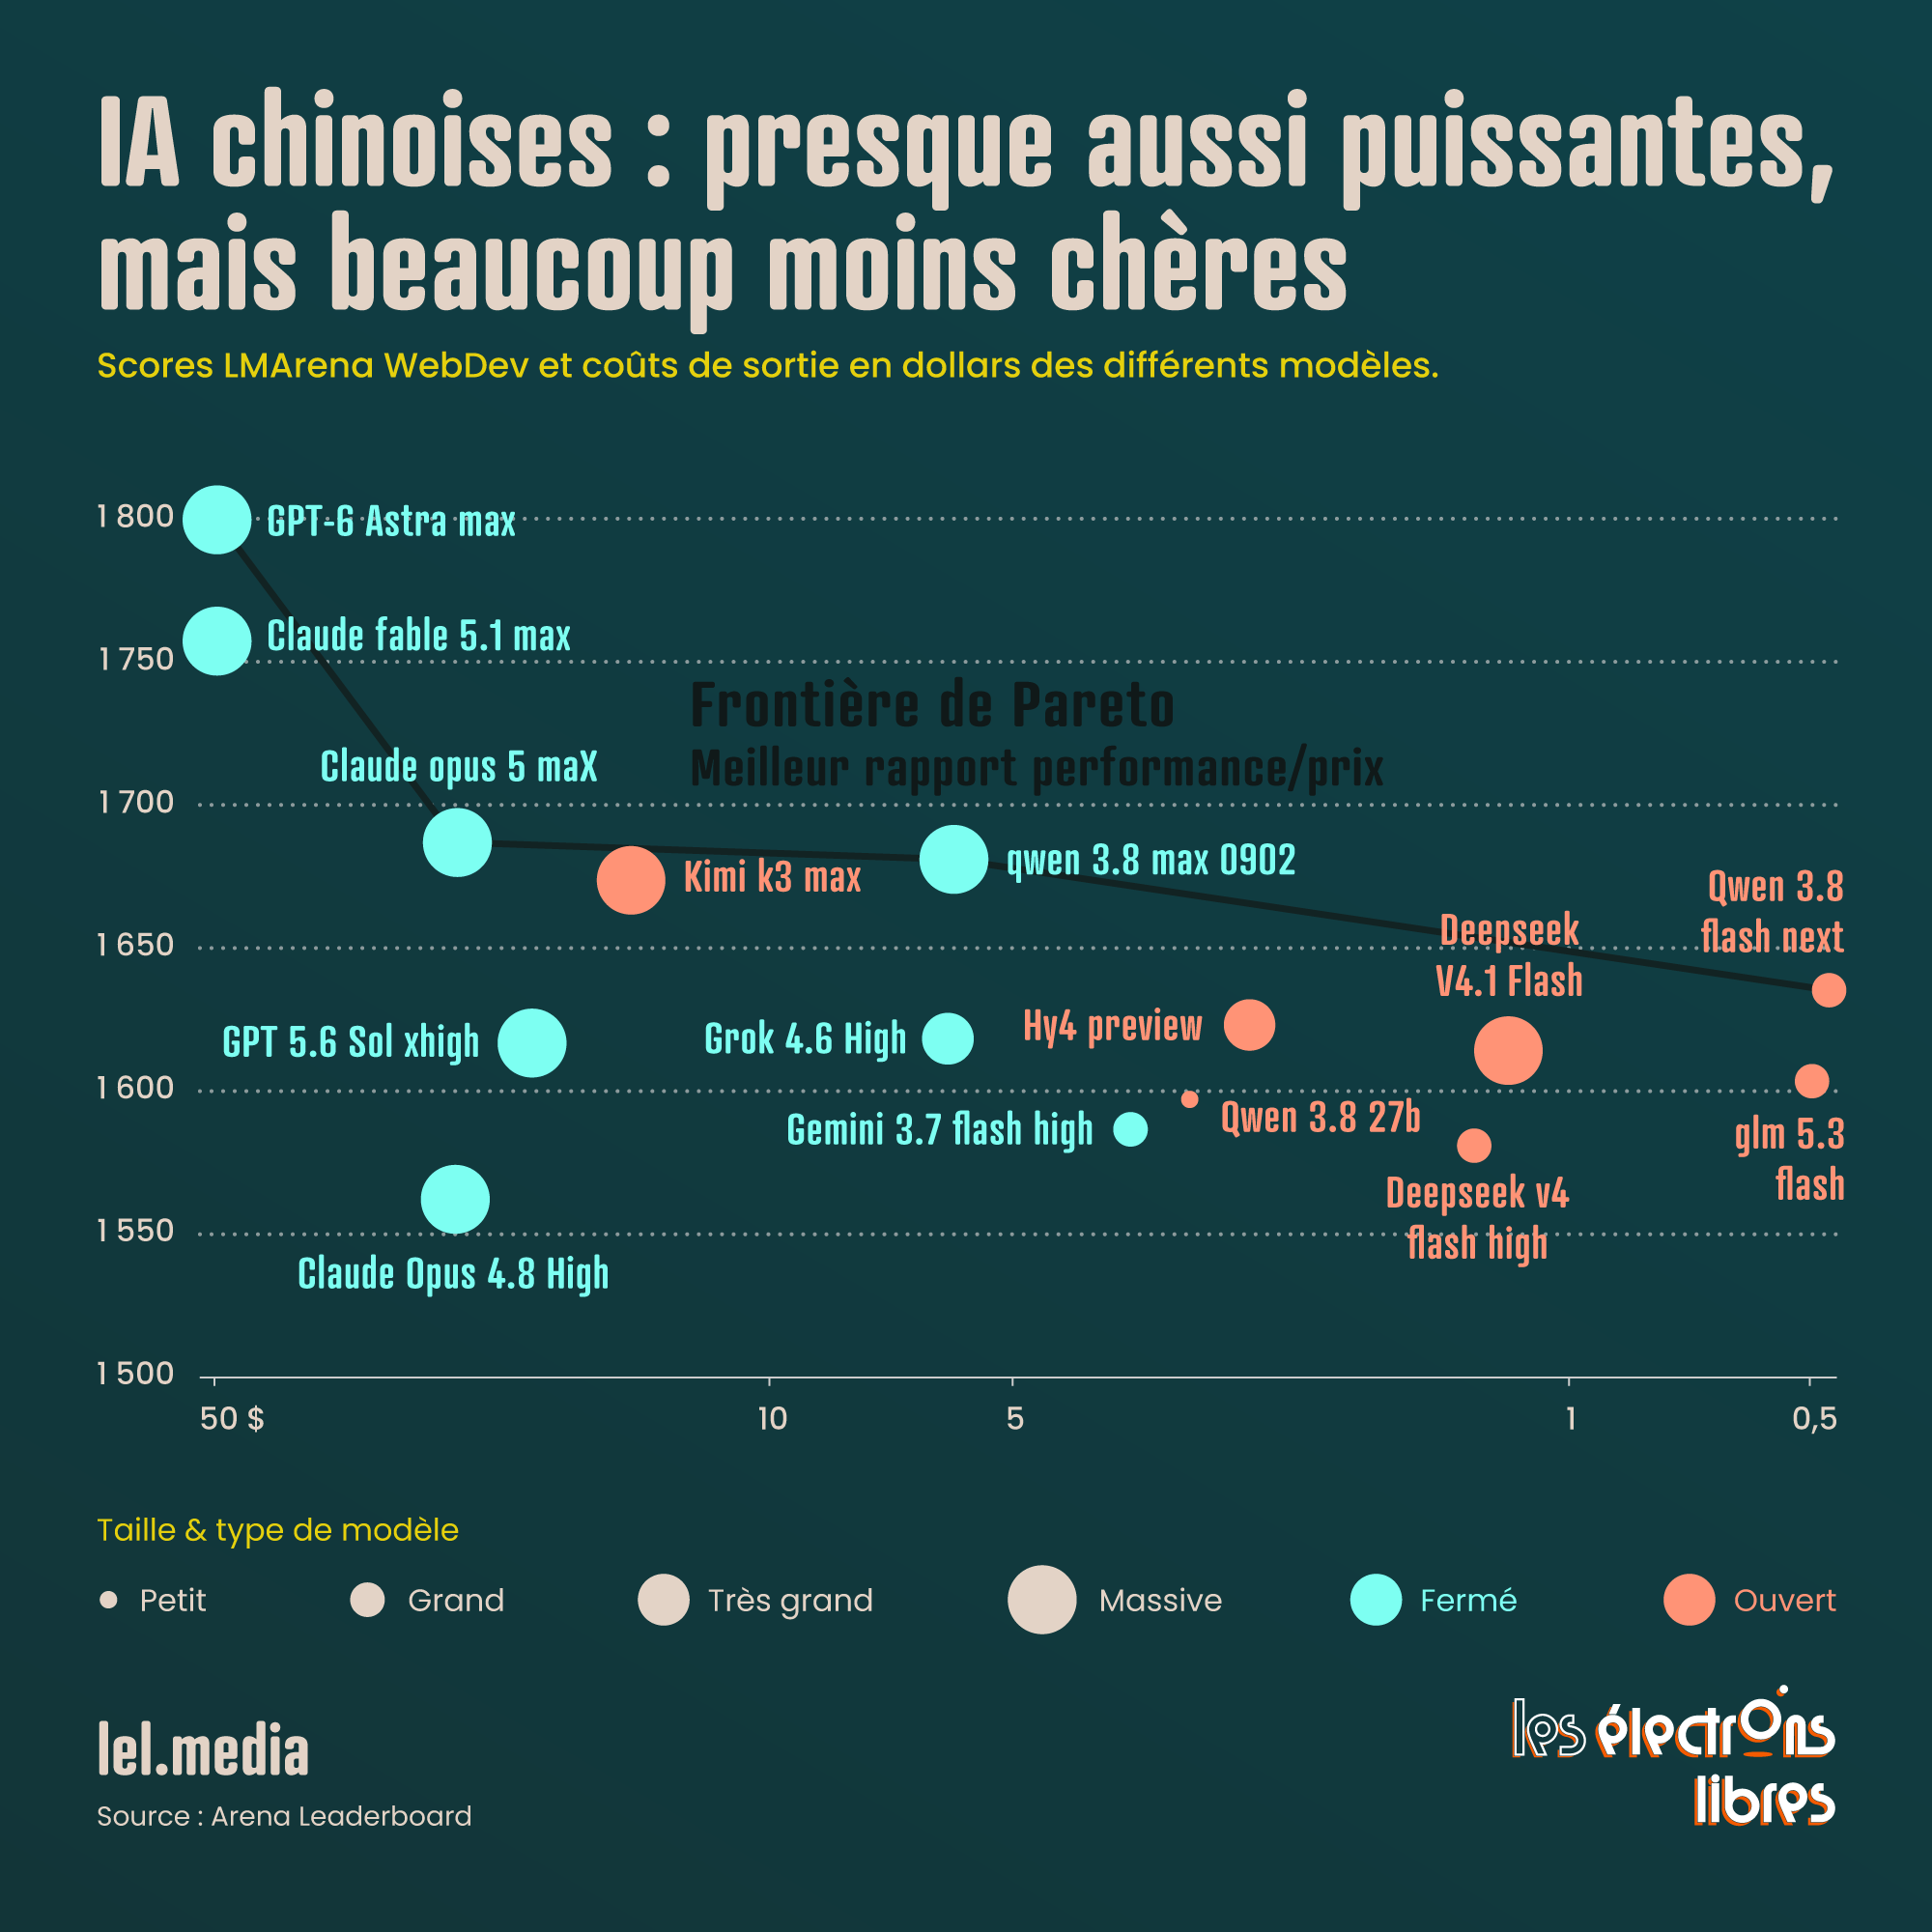
Cet été 2026, la véritable révolution de l’intelligence artificielle ne vient pas de modèles gigantesques enfermés dans des supercalculateurs IA américains. Elle s’incarne dans des modèles asiatiques de taille réduite, comme Qwen 3.8 Flash Next, GLM 5.3 Flash ou DeepSeek V4.1 Flash. Leur exploit ? Déplacer ce que les ingénieurs appellent la « frontière de Pareto » : le meilleur compromis disponible entre coût d’inférence, vitesse et performances. Sur certains usages, ils sont désormais supérieurs aux modèles de l’Oncle Sam sur ces trois dimensions. Aujourd’hui, les entreprises peuvent enfin faire tourner des IA surpuissantes et ultra-rapides directement sur leurs propres serveurs sans avoir à faire de gros sacrifices financiers.
Jusqu’à peu, la règle était simple : pour avoir une IA capable de coder, de comprendre des images ou d’utiliser des outils de manière autonome, les modèles les plus performants restaient généralement accessibles via les abonnements ou les API payantes d’OpenAI, Google ou Anthropic. Mais en l’espace de quelques mois, une nouvelle génération de modèles « compacts » et téléchargeables librement a rebattu les cartes.
La guerre des modèles ouverts : un cercle vertueux
Pour comprendre la folie de cet été, il faut regarder à quelle vitesse ces modèles se sont dépassés les uns les autres. La nouvelle bataille ne se joue plus seulement sur la taille, mais sur la fulgurance. C’est l’ère des modèles « Flash ». En l’espace de quelques semaines, nous avons assisté à une course poursuite effrénée pour repousser la frontière de l’efficacité : Qwen 3.8 (27B), DeepSeek V4 Flash 0731, Qwen 3.8 Flash Next, GLM 5.3 Flash, DeepSeek V4.1 Flash…
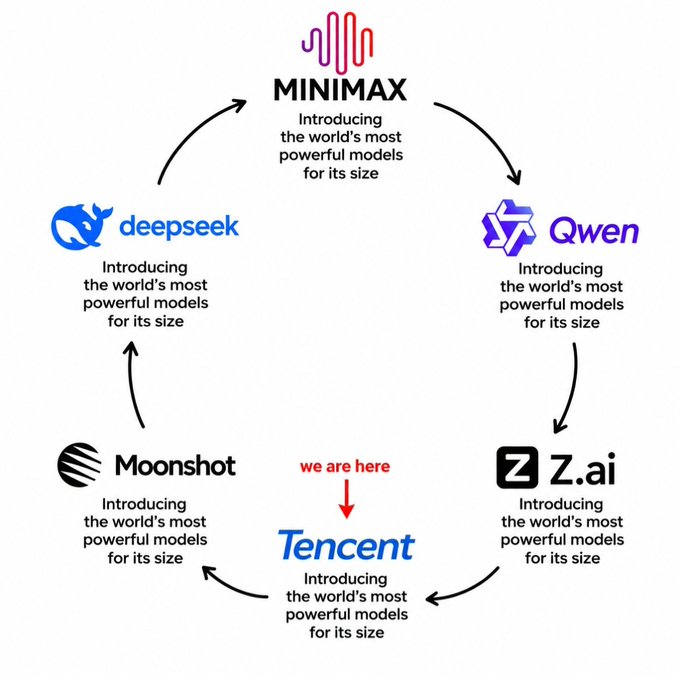
Sur X, un mème résume bien le cercle vertueux qui s’est installé entre les concepteurs chinois de modèles à poids ouverts : chacun reprend, optimise ou dépasse les avancées du précédent.
Le symbole ultime de ce basculement géopolitique et technologique se trouve en Europe, où, choisissant d’assumer un rôle de plateforme autant que de laboratoire, notre pépite nationale Mistral AI vient de faire preuve d’un pragmatisme radical. L’entreprise française a purement et simplement intégré le modèle chinois GLM 5.2 comme modèle tiers sur sa propre plateforme d’IA (de fait, il dépasse les scores des meilleurs modèles de Mistral dans pratiquement tous les tests sur les plateformes de référence LMArena et Artificial Analysis). Le message est clair : à défaut de remporter la course aux modèles les plus avancés, l’Europe choisit de s’imposer sur l’infrastructure et la souveraineté, en hébergeant l’état de l’art mondial sous ses propres conditions de sécurité. Techniquement, rien n’empêcherait Mistral de partir de certains de ces très bons modèles pour les enrichir avec ses propres données d’entraînement et s’insérer ainsi dans ce cercle vertueux.

Le cas d’école Qwen 3.8 : un « tueur de géants » dans votre ordinateur
Ce rattrapage s’incarne parfaitement dans l’architecture Qwen 3.8 (dans sa version « classique » 27B) qui avec ses 27 milliards de paramètres, une fois compressés, ne pèse plus que 17 Go, contre 56 Go dans son format d’origine, au prix d’une dégradation limitée des performances. C’est suffisamment léger pour tourner de manière fluide sur un ordinateur personnel récent (comme un MacBook musclé ou un PC gaming avec une grosse carte graphique) ou sur le petit serveur IA interne d’une PME. On peut l’utiliser sans aucune connexion internet via des logiciels gratuits comme LM Studio ou Ollama, installables en quelques clics — ou, côté production, vLLM, SGLang ou la solution française ZML, des moteurs d’inférence pour servir ces modèles à l’échelle.
Pourtant, malgré sa taille de guêpe, il est « multimodal » : il lit du texte, analyse des images, décortique des vidéos et peut appeler des outils externes — par exemple rechercher un fichier, chercher sur le web, exécuter du code ou enchaîner plusieurs tâches sous supervision.
Les chiffres (voir premier graphique) donnent le vertige : sur WebDev Arena de LMArena, où des évaluateurs humains comparent en duel des interfaces web générées par les modèles, ce petit modèle gratuit, avec un score de 1 597 égale, voire dépasse légèrement le score de Claude Opus 4.8 (1 563), le modèle massif et payant d’Anthropic, au moins 50 fois plus lourd en nombre de paramètres (et donc en coût d’infrastructure) ! Le simple fait qu’un petit modèle puisse rivaliser avec ce type d’IA est un tournant historique.

Ce que cela change pour les entreprises : l’ère de l’IA locale
Au-delà de la course entre ces modèles open-weight qui ont de moins en moins de retard, cet été a marqué une bascule fondamentale pour le monde professionnel.
Jusqu’ici, beaucoup d’entreprises (banques, santé, défense, cabinets juridiques) hésitaient à déployer l’IA, refusant d’envoyer leurs données confidentielles sur les serveurs d’un fournisseur extérieur. Ce verrou vient de sauter.
Si les laboratoires chinois inondent le marché de modèles surpuissants en accès libre, ce n’est pas par altruisme. La stratégie de Pékin est redoutable : banaliser l’intelligence artificielle pour saborder le modèle économique des géants américains, fondé sur la rente des abonnements cloud et des API fermées. Et cette guerre d’usure déstabilise les États-Unis jusque sur leur propre sol.
L’exemple de Latham & Watkins, deuxième plus gros cabinet d’avocats américain, est à ce titre un cas d’école. Comme l’a révélé le Financial Times, la firme a décidé de s’affranchir d’OpenAI et d’Anthropic en achetant ses propres grappes de serveurs Nvidia pour y spécialiser des modèles ouverts en vase clos. Le but ? Garantir le secret professionnel absolu à ses clients tout en refusant d’être pris en otage par les tarifs de la Silicon Valley. Le constat est le même dans le secteur très sensible de la défense. Le géant américain L3Harris, épaulé par Palantir, vient d’annoncer avoir réduit sa facture d’IA de 95 %. Leur conclusion commence à sérieusement inquiéter les géants de la Silicon Valley :
« En affinant des modèles ouverts sur nos propres données, nous avons pu surpasser les modèles de pointe (dits ‹ Frontière ›) en moins de 48 heures. »
De quoi donner des sueurs froides aux laboratoires d’IA américains. À l’heure où ces spécialistes des modèles fermés peaufinent leurs futures introductions en Bourse, voir leur rente technologique ainsi court-circuitée passe mal. Dès lors, le récent discours alarmiste de leurs dirigeants prend un tout autre sens. Lorsqu’ils agitent la peur panique d’une technologie tellement incroyable qu’il faudrait d’urgence en restreindre l’accès par la loi, difficile de ne pas y voir une tentative de protectionnisme déguisée pour freiner la concurrence.
Mais la machine est lancée, et pour le reste du tissu économique, c’est une aubaine. Il est désormais techniquement et financièrement viable pour une entreprise d’installer en local un modèle capable de fouiller dans des bases de données internes sans transmettre leur contenu à un fournisseur externe ; de générer et corriger du code informatique ; d’analyser des documents visuels complexes… Et enfin de piloter des agents autonomes pour automatiser des processus.
Le basculement de 2026 ne correspond pas à l’apparition d’un nouveau cerveau surpuissant, même si les progrès de niveau d’intelligence des modèles sont indéniables et impressionnants. Il figure la démocratisation d’une intelligence de pointe, fulgurante, auto-hébergée, capable de tenir sur un simple serveur IA d’entreprise à moins de 20 000 euros pour une quinzaine d’utilisateurs simultanés. L’IA locale ne se contente plus de parler. Désormais, elle voit, elle code et elle agit « comme une grande ».


 Reportage en Ukraine : Les missiles de l’espoir


